Outil
Dam Levels Data, ontologie et serveur MCP
Onze ans de bulletins quotidiens des barrages tunisiens (2014–2025) : un jeu de données ouvert et audité, une ontologie et un serveur MCP en lecture seule.
Les 36 grands barrages de Tunisie, au 10 octobre
Carte : touches fléchées pour passer d'un barrage à l'autre.
649,3 millions de m³ stockés
27,4 % de la capacité
18 barrages remplis à moins d'un quart
36 barrages publiés ce jour-là · 10 octobre 2025
- 10 %
- 25 %
- 50 %
- 75 %
- 100 %
- capacité inconnue
- pas de valeur publiée
- transfert entre barrages
Totaux nationaux, 2014–2025
| Année | Stock (Mm³) | Remplissage | Barrages | < 25 % |
|---|---|---|---|---|
| 2014 | 1 178,6 | 55,8 % | 26 | 8 |
| 2015 | 1 139,3 | 54,2 % | 26 | 8 |
| 2016 | 659,7 | 33,0 % | 26 | 16 |
| 2017 | 585,8 | 28,2 % | 30 | 15 |
| 2018 | 895,6 | 41,3 % | 32 | 9 |
| 2019 | 1 392,8 | 61,8 % | 33 | 7 |
| 2020 | 965,8 | 42,6 % | 34 | 10 |
| 2021 | 669,2 | 28,7 % | 36 | 23 |
| 2022 | 735,5 | 31,4 % | 36 | 20 |
| 2023 | 579,0 | 24,8 % | 36 | 22 |
| 2024 | 501,4 | 21,2 % | 36 | 24 |
| 2025 | 649,3 | 27,4 % | 36 | 18 |
Valeurs par barrage : survolez ou parcourez la carte au clavier. Toutes les données quotidiennes : dossier data/ du dépôt DamLevels-Data (storage.csv, CC BY 4.0)
Qu’est-ce que c’est
DamLevels-Data reconstitue l’état quotidien des 36 grands barrages de la Tunisie à partir des bulletins Situation des barrages que la Direction Générale des Barrages et des Grands Travaux Hydrauliques (DGBGTH) publie par l’intermédiaire de l’Observatoire National de l’Agriculture (ONAGRI) (onagri.nat.tn). Ces bulletins sont publics, mais n’existent que sous forme de PDF de trois pages dont la mise en page a changé au fil des ans. L’archive couvre la période du 2 juillet 2014 au 10 octobre 2025 : 3 985 dates de bulletin, 11 927 pages PDF et 129 390 valeurs quotidiennes de stock, chacune reliée au fichier, à la page, à la colonne et aux caractères imprimés dont elle provient. Le 10 octobre 2025, dernière date de l’archive, les 36 barrages contenaient 649,3 millions de m³, soit 27,4 % de leur capacité, et 18 d’entre eux étaient remplis à moins d’un quart ; le même jour en 2019, les 33 barrages alors publiés contenaient 1 392,8 millions de m³.
Elle est publiée sous forme d’un paquet ouvert — tableaux, provenance, indicateurs de qualité, couches SIG et l’ontologie DamLevels (DLO 0.3) — et d’un serveur MCP en lecture seule, grâce auquel un assistant IA peut répondre aux questions à partir de l’archive. Projet indépendant et non officiel, sans aucune affiliation avec la DGBGTH, l’ONAGRI ou le Ministère de l’Agriculture, ni approbation de leur part.
Du bulletin PDF à l’assistant IA
Le travail suit le modèle cinq étoiles des données ouvertes, d’un document sur le web vers les données liées, et ajoute une étape au-dessus : un serveur MCP que les assistants IA peuvent interroger.
Du bulletin PDF au serveur MCP, en six étapes
-
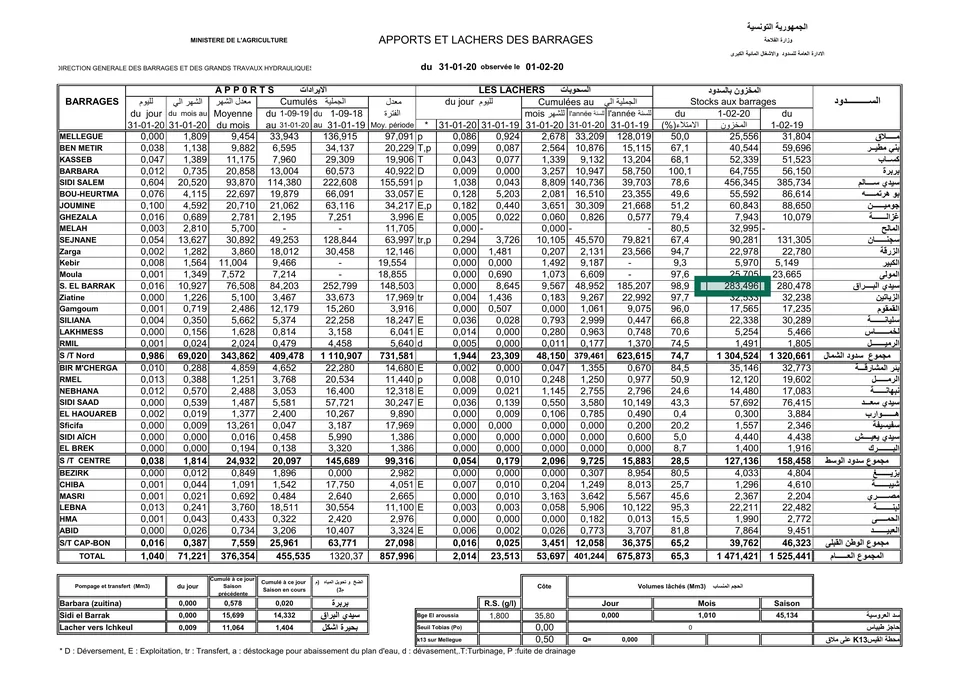
★
Une source publique, enfermée dans un PDF
3 985 bulletins quotidiens de la DGBGTH, publiés par l'ONAGRI, du 2 juillet 2014 au 10 octobre 2025.
-
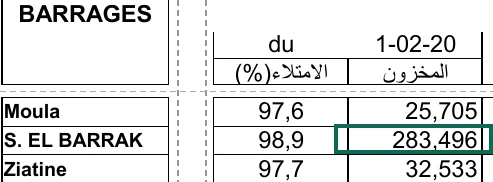
★★
Lu, jamais ressaisi
Des moteurs déterministes lisent 11 927 pages, sans OCR. Chaque valeur garde son passeport.
-
★★★
Un paquet ouvert et audité
129 390 valeurs quotidiennes pour 36 barrages, en CSV et Parquet, vérifiées de cinq manières complémentaires.
-
★★★★
Un identifiant pour chaque chose
Barrages, observations et pages ont des identifiants stables, dans un espace de noms réservé ; la version a un DOI.
-
★★★★★
Des données liées par une ontologie
84 colonnes imprimées, 33 concepts, 16 règles de temps (DLO 0.3), sur les vocabulaires W3C/OGC SOSA, OWL-Time, QUDT et PROV : chaque valeur sait ce qu'elle mesure, où et pour quel jour.
-
MCP
Interrogeable par un assistant IA
Le serveur MCP répond depuis l'archive, ne comble jamais un trou et cite la page source.
Comment ça fonctionne
Des moteurs déterministes lisent la couche texte des PDF et les traits des
tableaux — sans OCR ni ressaisie — de sorte qu’un même fichier donne
toujours les mêmes valeurs. Les noms des barrages, imprimés en français et en
arabe avec des graphies variables, sont rattachés à des identifiants stables
(dam_id). Les valeurs manquantes restent manquantes : rien n’est interpolé,
reporté ni remplacé par zéro. L’ontologie écrit ce que signifie réellement
chaque colonne imprimée et le jour qu’elle décrit : les débits imprimés sur le
bulletin du jour J portent sur le jour J−1, et l’une des deux colonnes
« lâchers du jour » donne en fait les lâchers de l’année précédente.
Le serveur MCP expose dix outils en lecture seule — find_dam, list_dams,
get_storage, get_fill, national_storage, compare_years, get_source,
get_transfers, describe_variable et dataset_info. Il refuse les dates
hors de l’archive et les saisies mal formées par une erreur explicite plutôt
que par une réponse vide, utilise la capacité en vigueur à chaque date, marque
les transferts de la page 3 comme PROBABLE, renvoie tous les candidats
lorsqu’un nom ou un terme est ambigu, et joint à chaque réponse sa couverture,
l’attribution de la source et ses réserves.
Cas d’usage
- Recherche en hydrologie et climat : comparer le stock d’un barrage au même jour calendaire sur onze ans, les jours manquants étant signalés comme manquants.
- Journalisme : vérifier un chiffre cité dans la presse en remontant au bulletin d’origine, jusqu’à la page, la colonne et les caractères imprimés.
- Politique publique : suivre la réserve nationale : 649 millions de m³, soit 27 % de la capacité, le 10 octobre 2025, avec 18 barrages sur 36 remplis à moins d’un quart.
Démo — exemple illustratif
Exemple illustratif — réponse réelle capturée le 2026-10-12
Question posée : « Quel était le taux de remplissage de Sidi Salem le 10 octobre 2025, et d’où vient ce chiffre ? »
{
"dam": { "dam_id": "sidisalem", "name_fr": "Sidi Salem" },
"date": "2025-10-10",
"storage_mm3": 137.196,
"capacity": { "status": "KNOWN", "capacity_mm3": 580.35 },
"fill_pct": 23.6, "printed_fill_pct": 23.6,
"source": {
  "source_file": "10-10-2025_1.pdf", "page": "1",
  "printed_text": "137,196",
  "bulletin_url": "https://www.onagri.nat.tn/uploads/barrages/BARRAGES-10-10-2025.pdf"
}
}
Extrait des réponses de get_fill et get_source.
Source : bulletin de la DGBGTH du 10 octobre 2025, page 1, publié par
l’ONAGRI. Le taux de remplissage utilise la capacité en vigueur ce jour-là
et correspond à celui imprimé dans le bulletin. Une question sur une date
postérieure au 10 octobre 2025 renvoie OUTSIDE_RECORD :
l’archive est close et rien n’est estimé.
Statut et feuille de route
DamLevels-Data est open source et auto-hébergé : le serveur MCP s’exécute comme un processus stdio local à partir d’une copie du dépôt, sans endpoint distant. La version 1.1.2 est archivée sur Zenodo. Le dépôt GitHub est la source unique pour les données, l’installation et le code. Prochaines étapes prévues : enregistrer l’espace de noms de l’ontologie et publier le graphe complet, relier les barrages et les bassins versants à des jeux de données externes, publier la couche climatique des bassins versants (pluie, météorologie, humidité du sol), et résoudre avec l’éditeur les questions ouvertes sur les transferts de la page 3.
Rapport technique
Le rapport technique TD-TR-2026-04 (en anglais) documente chaque étape, du bulletin PDF aux données liées et au serveur MCP, avec ses preuves et ses limites, sous licence CC BY 4.0.
Télécharger le rapport technique (PDF)Version d’archive citable faisant foi : Nasfi, M. H., Boulaares, S., & Gasmi, T. (2026). DamLevels-Data: From PDF Bulletins to Linked, AI-Queryable Open Data on Tunisia’s Large Dams, 2014–2025. Technical report TD-TR-2026-04. tanitdata, Tunis. https://doi.org/10.5281/zenodo.23305079
Données et logiciel (version 1.1.2) : Nasfi, M. H., Boulaares, S., & Gasmi, T. (2026). DamLevels-Data: daily storage of Tunisia’s 36 large dams, 2014–2025. Zenodo. https://doi.org/10.5281/zenodo.23304326
Code source et données : github.com/tanitdata/DamLevels-Data
Cet outil est conçu et maintenu selon le protocole de recherche et d'ingénierie du studio. Notre méthode
FAQ
- Qu'est-ce que le Model Context Protocol ?
- Le Model Context Protocol est un standard ouvert permettant aux assistants IA d'appeler des outils externes. Le serveur MCP DamLevels est l'un de ces outils : connectez-le à votre client IA (Claude Desktop, Claude Code ou tout client compatible MCP) et interrogez l'archive des barrages tunisiens en français, en anglais ou en arabe.
- À qui s'adresse cet outil ?
- Aux chercheurs, journalistes, étudiants et institutions qui ont besoin du stock des barrages tunisiens avec sa date et sa source : hydrologues qui comparent les années, journalistes qui vérifient un chiffre, analystes qui suivent la réserve nationale.
- Faut-il le serveur MCP pour utiliser les données ?
- Non. Les tableaux sont de simples fichiers CSV et Parquet dans le dépôt, documentés par un dictionnaire de données et un descripteur Frictionless ; ils s'ouvrent dans Excel, pandas, R ou QGIS. Le serveur MCP est un moyen supplémentaire de les interroger en langage naturel.
- Faut-il un compte ou une clé d'API ?
- Non. Le serveur s'exécute localement via stdio et lit les tableaux du dépôt ; aucune clé et aucune connexion réseau au moment des requêtes.
- À quelle fréquence les données sont-elles mises à jour ?
- Il s'agit d'une archive historique close : du 2 juillet 2014 au 10 octobre 2025. Aucun bulletin ultérieur n'est inclus, et le serveur refuse les dates hors de l'archive au lieu de les estimer.
- Les données sont-elles librement réutilisables ?
- Les valeurs sources sont celles de la DGBGTH, publiées par l'ONAGRI, et réutilisées sous la Licence Nationale de Données Publiques Ouvertes (LNDPO) avec attribution. Les tableaux, la documentation et l'ontologie du projet sont sous CC BY 4.0 ; les couches SIG des bassins versants, dérivées de FABDEM et MERIT Hydro, sont sous CC BY-NC-SA 4.0 (usage non commercial) ; le code est sous MIT. Il s'agit d'un projet indépendant et non officiel.
- Comment les données ont-elles été vérifiées ?
- Par cinq contrôles complémentaires, chacun avec son propre dénominateur : la page 1 contre la page 2 (128 995 paires de stock égales sur 128 996), les barrages contre le total national imprimé (3 965 bulletins sur 3 967), les cumuls contre les valeurs quotidiennes, le taux de remplissage imprimé contre le stock et la capacité (84 470 lignes sur 84 471), et un échantillon de 2 392 cellules relues dans les PDF originaux (toutes correctes). Les erreurs de la source elle-même sont documentées, jamais corrigées.
- Comment contribuer ?
- Le code et les données sont publiés sur GitHub. Ouvrez une issue ou une pull request pour signaler un problème ou proposer une amélioration.